Le 12 octobre, Meta a lancé la série Muse Wonder, renouant ainsi avec la compétition des grands modèles de pointe. Dans le même temps, Microsoft prépare un déploiement à grande échelle de sa puce d’inférence de nouvelle génération, tandis qu’Anthropic fait le point sur ses avancées contre les attaques par distillation de modèles. Aujourd’hui, l’actualité ne se limite pas aux scores des modèles : elle concerne aussi la mémoire des agents, l’efficacité de calcul et les limites de sécurité.[1][2][3][4]
À la une : Meta lance Muse Wonder et met la mémoire à long terme au premier plan
Meta Superintelligence Labs a dévoilé deux modèles de pointe, Muse Wonder et Muse Wonder Full. Contrairement à Muse Spark, qui met l’accent sur une faible latence, la série Wonder est davantage axée sur les tâches complexes, la programmation et l’exécution en plusieurs étapes. Meta affirme que les nouveaux modèles peuvent traiter des demandes d’indemnisation, des contrats de location et du développement d’applications, et obtiennent des résultats compétitifs sur plusieurs benchmarks publiés par l’entreprise. Il faut toutefois noter que ces performances reposent principalement sur des résultats de tests communiqués par Meta et ne signifient pas qu’elles ont été validées de manière indépendante dans tous les contextes professionnels réels.[1][2]
Cette annonce met particulièrement en avant deux capacités : Active Memory (mémoire active), qui conserve au fil des sessions des informations importantes pour l’utilisateur, et Active Focus (concentration active), qui cherche d’autres méthodes lorsque la tâche rencontre un obstacle, corrige les erreurs et demande confirmation avant les actions importantes. Ces fonctions répondent à des difficultés courantes lors de l’utilisation quotidienne d’agents : un assistant doit non seulement répondre à la question du moment, mais aussi comprendre le contexte, garder le cap sur la tâche pendant plusieurs jours ou davantage, et éviter de modifier arbitrairement les intentions de l’utilisateur en cas d’imprévu. Si ces capacités deviennent fiables et stables, l’IA pourrait passer du statut d’outil de questions-réponses ponctuel à celui de véritable assistant de travail capable de collaborer sur la durée.[2]
Les modalités de commercialisation ont également été dévoilées : Muse Wonder est proposé aux développeurs via Meta Model API et Muse Code. Selon TechCrunch, l’API coûte 4 dollars par million de tokens en entrée et 20 dollars par million de tokens en sortie. Muse Wonder Full est pour l’instant réservé aux abonnés de Muse Code et n’est pas disponible directement via l’API. Meta prévoit également d’intégrer progressivement les nouveaux modèles à l’agent Muse, en commençant par les abonnés. Il faudra suivre non pas un classement isolé, mais la précision de la mémoire à long terme, la capacité des utilisateurs à contrôler réellement les autorisations liées à la vie privée, ainsi que la stabilité d’exécution des tâches complexes à un coût acceptable.[1][2]
À retenir
Microsoft prévoit de déployer Maia 300 à partir de 2027, l’efficacité d’inférence au cœur de la compétition entre les puces
Le 12 octobre, Microsoft a dévoilé la suite de sa feuille de route Azure Maia, avec un déploiement à plusieurs gigawatts prévu dès 2027. Maia 200 prend déjà en charge certaines charges de travail de production des produits Microsoft ; Maia 300, lui, est conçu pour les longs contextes, les conversations à faible latence et les agents autonomes exécutant des tâches en plusieurs étapes de façon continue. Microsoft estime que Maia 300 pourra générer 40 % de tokens en plus par mégawatt que les solutions GPU de pointe, et qu’un rack de 96 accélérateurs pourra offrir un débit jusqu’à sept fois supérieur à celui de Maia 200. Il s’agit d’objectifs de conception et de performances communiqués par Microsoft, et non de résultats issus d’une comparaison indépendante en environnement de production ouvert. Cela montre que Microsoft veut optimiser conjointement les puces et les logiciels afin de mieux maîtriser les coûts d’inférence de l’IA.[3]
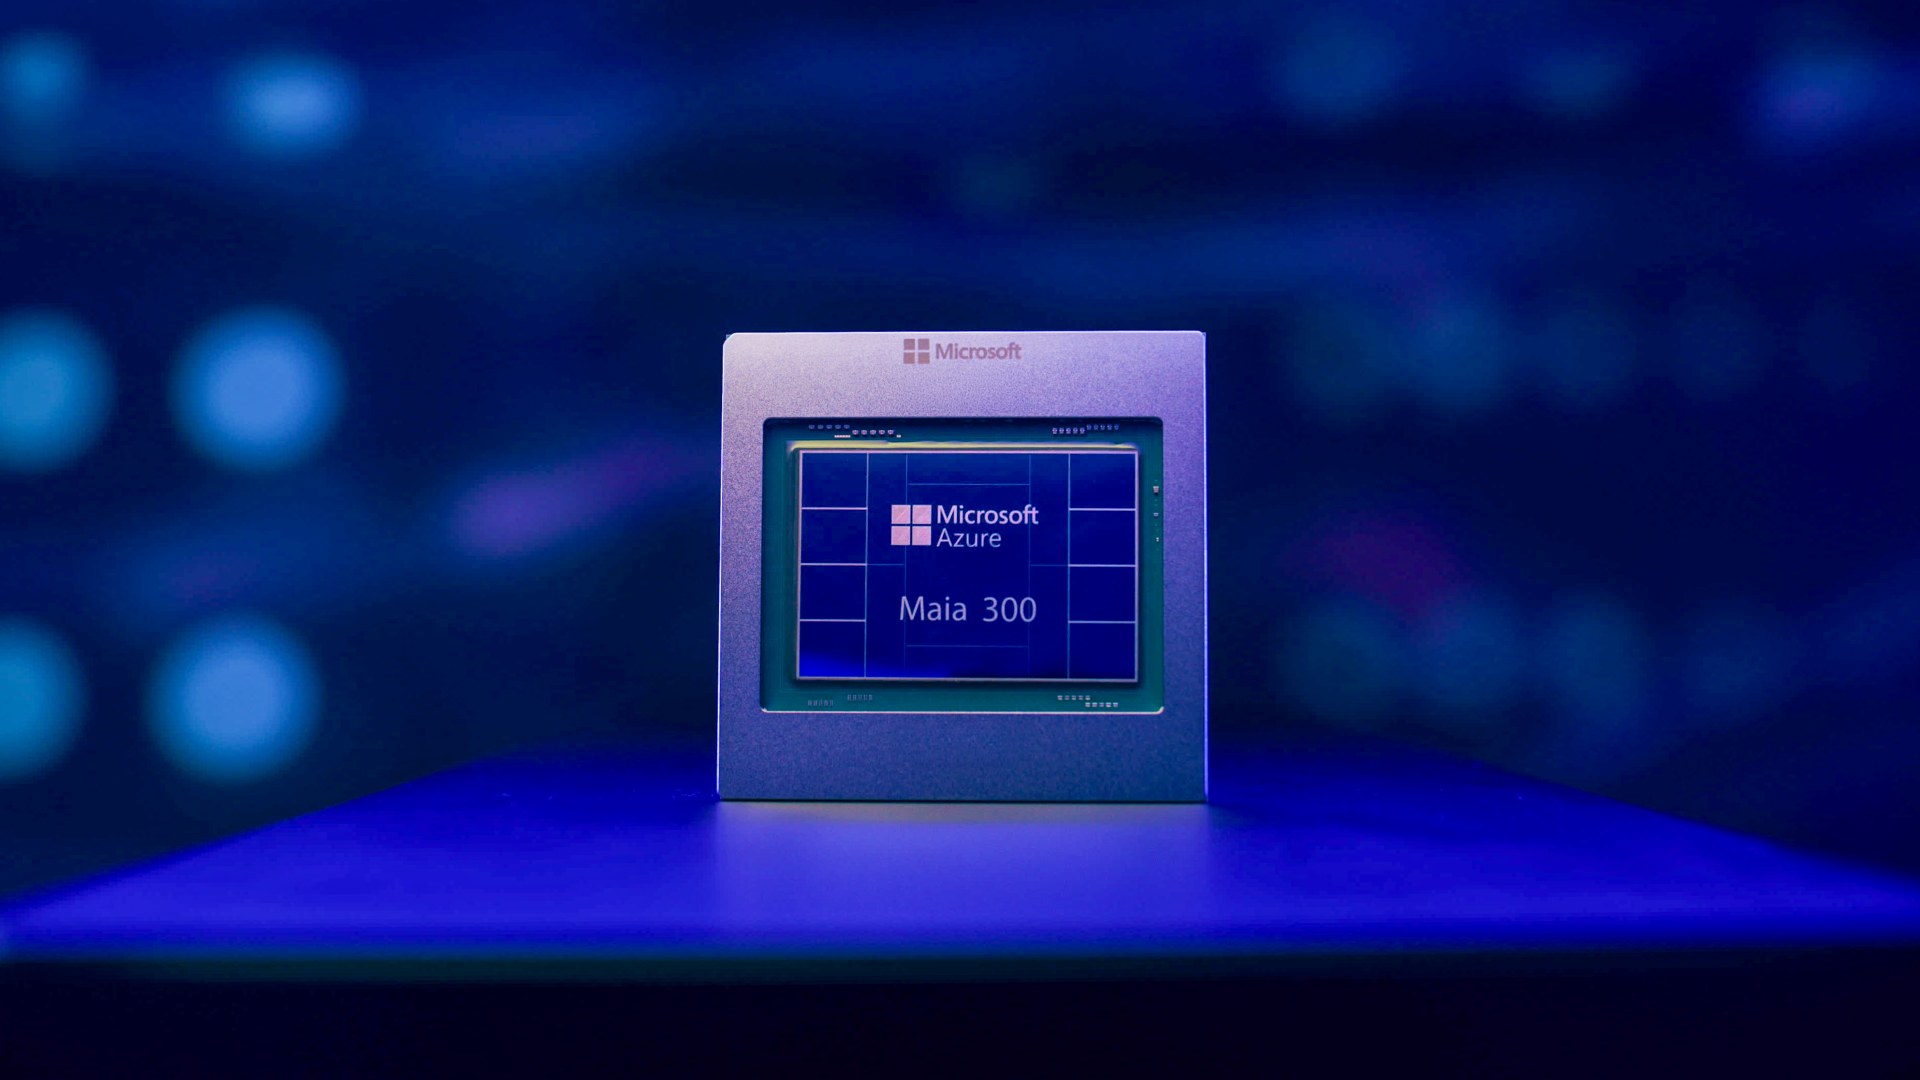
Image : visuel officiel de la puce Microsoft Azure Maia 300 (source : Microsoft)
Anthropic présente des avancées contre la distillation non autorisée, mais leur efficacité reste à vérifier sur le long terme
Anthropic a indiqué que, depuis la mise en place de nouvelles mesures contre la distillation non autorisée de modèles, les premières données montrent une baisse d’environ 90 à 99 % du volume de données que les attaquants peuvent collecter. La distillation est une technique courante d’apprentissage automatique qui consiste à entraîner un modèle à partir des réponses d’un modèle plus puissant ; la controverse porte sur l’autorisation de cette extraction et sur le contournement éventuel des limites du service. Anthropic reconnaît également que certaines mesures de protection obligent les clients légitimes à modifier leur intégration et impliquent des compromis en matière de coûts et de revenus. Ces résultats reposent sur les premières observations de l’entreprise : ils ne signifient pas que tous les risques d’extraction des capacités des modèles ont disparu.[4]
NVIDIA et Cisco misent sur des modules optiques à haute densité pour interconnecter les centres de données dédiés à l’IA
NVIDIA et Cisco ont annoncé une solution de modules optiques enfichables USFP destinée aux transmissions à haut débit dans les grands centres de données consacrés à l’IA. Elle vise notamment 400 Gb/s par voie et une capacité totale pouvant atteindre 12,8 Tb/s. Selon les deux entreprises, par rapport aux modules optiques enfichables de 200 Gb/s par voie, la nouvelle solution peut quadrupler la densité de bande passante et améliorer l’efficacité énergétique d’environ 1,3 fois. À mesure que les modèles prennent de l’ampleur, l’efficacité dépend non seulement des puces, mais aussi de la capacité à transmettre les données entre des milliers d’accélérateurs. Toutefois, le passage des spécifications et des projets de collaboration au déploiement en production nécessitera encore des validations de l’écosystème matériel, de la compatibilité et de la consommation énergétique en conditions réelles.[5]
En bref
- La start-up d’architecture Blueprint AI a présenté une nouvelle génération d’outils capables de générer automatiquement des plans d’exécution architecturaux. L’équipe souligne que les documents destinés à une demande de permis doivent toujours être vérifiés et tamponnés par un architecte agréé : l’IA ne peut pas se substituer à la responsabilité juridique des professionnels.[6]
- WindBorne a obtenu un contrat d’achat de données météorologiques auprès de l’US Air Force, d’une valeur potentielle proche de 50 millions de dollars. Les observations recueillies par ses ballons météorologiques autonomes servent à ses clients et contribuent également à améliorer les modèles de prévision météorologique fondés sur l’IA.[7]
Point de vue de la rédaction
Ces actualités semblent disparates, mais elles couvrent en réalité la même chaîne de valeur de l’IA : Meta cherche à améliorer la compréhension des tâches continues par les agents ; Microsoft, Nvidia et Cisco s’efforcent d’optimiser l’efficacité des infrastructures nécessaires à leur exécution sur la durée ; Anthropic, de son côté, renforce les capacités de ses modèles et les limites d’accès aux données. Il convient de rappeler qu’une démonstration technologique, un test interne et un déploiement réel en production ne sont pas la même chose. Selon nous, la prochaine étape se jouera probablement sur la capacité des modèles à fonctionner de manière fiable dans des contextes métier précis, la baisse durable des coûts et la possibilité pour les utilisateurs de garder véritablement la maîtrise des contrôles en matière de confidentialité et de sécurité — et non sur l’avance affichée dans un test de référence.
Sources de référence
- Meta releases its first frontier model, Muse Wonder — TechCrunch, consulté le 2026-10-13
- Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents — Meta, consulté le 2026-10-13
- Microsoft to expand Azure Maia system to multi-gigawatt deployments — Microsoft, consulté le 2026-10-13
- Strengthening our defenses against distillation attacks — Anthropic, consulté le 2026-10-13
- NVIDIA and Cisco Introduce New Pluggable Optics Form Factor to Scale AI Factories — NVIDIA Newsroom, consulté le 2026-10-13
- This AI startup says it can generate permit-ready blueprints in minutes — TechCrunch, consulté le 2026-10-13
- WindBorne wins a hefty US Air Force contract for its balloon data — TechCrunch, consulté le 2026-10-13