Meta presentó la serie Muse Wonder el 12 de octubre, reincorporándose a la competencia por los grandes modelos de vanguardia. Mientras tanto, Microsoft ha trazado una hoja de ruta para el despliegue a gran escala de su chip de inferencia de próxima generación, y Anthropic ha actualizado los avances en la defensa contra los ataques de destilación de modelos. Hoy, el foco no está solo en las puntuaciones de los modelos, sino también en la memoria de los agentes, la eficiencia de cómputo y los límites de seguridad.[1][2][3][4]
Titular de hoy: Meta presenta Muse Wonder y pone la memoria a largo plazo en primer plano
Meta Superintelligence Labs ha presentado dos modelos de vanguardia, Muse Wonder y Muse Wonder Full. A diferencia de Muse Spark, que prioriza la baja latencia, la serie Wonder pone más énfasis en las tareas complejas, la programación y la ejecución de varios pasos. Meta afirma que los nuevos modelos pueden gestionar tareas como reclamaciones de seguros, contratos de alquiler y desarrollo de aplicaciones, y que han obtenido resultados competitivos en varias pruebas de referencia publicadas por la empresa. Sin embargo, conviene tener en cuenta que estos resultados proceden principalmente de las pruebas publicadas por Meta y no implican que hayan sido validados de forma independiente en todo tipo de entornos empresariales reales.[1][2]
El lanzamiento destaca especialmente dos capacidades: Active Memory (memoria activa), que conserva información importante sobre el usuario a lo largo de varias sesiones; y Active Focus (enfoque activo), que intenta otros métodos, corrige errores y pide confirmación antes de acciones importantes cuando encuentra obstáculos. Ambas abordan problemas habituales en el uso diario de los agentes: un asistente no solo debe responder a la pregunta del momento, sino también comprender el contexto, mantener el objetivo de la tarea y evitar alterar a la ligera las intenciones del usuario cuando ocurre algo inesperado, incluso durante trabajos que duran días o más. Si estas capacidades se vuelven estables y fiables, la IA podría pasar de ser una herramienta para consultas puntuales a convertirse en un verdadero asistente de trabajo capaz de colaborar a largo plazo.[2]
También se han anunciado los planes de comercialización: Muse Wonder está disponible para desarrolladores a través de Meta Model API y Muse Code. Según TechCrunch, el precio de la API es de 4 dólares por millón de tokens de entrada y 20 dólares por millón de tokens de salida. Por ahora, Muse Wonder Full está disponible para los suscriptores de Muse Code y no se ofrece directamente a través de la API. Meta también planea incorporar gradualmente los nuevos modelos a los agentes Muse, empezando por los suscriptores. Lo que habrá que observar en el futuro no es un único ranking, sino si la memoria a largo plazo es precisa, si los usuarios pueden controlar realmente los permisos de privacidad y si las tareas complejas pueden ejecutarse de manera estable a un coste aceptable.[1][2]
Noticias destacadas
Microsoft planea desplegar Maia 300 en 2027 y la eficiencia de inferencia se convierte en un factor clave en la competencia entre chips
El 12 de octubre, Microsoft anunció la hoja de ruta de Azure Maia y sus planes para ampliar el despliegue hasta alcanzar varios gigavatios a partir de 2027. Maia 200 ya gestiona algunas cargas de trabajo de producción de productos de Microsoft; Maia 300 está diseñado para contextos largos, conversaciones de baja latencia y agentes de varios pasos en funcionamiento continuo. Microsoft estima que Maia 300 podrá generar un 40 % más de tokens por megavatio que las principales soluciones con GPU, y que un rack con 96 aceleradores podrá alcanzar hasta siete veces el rendimiento de Maia 200. Estas son metas de diseño y rendimiento divulgadas por Microsoft, no resultados de una comparación independiente en un entorno de producción pública. Esto demuestra que Microsoft aspira a optimizar conjuntamente el hardware y el software para controlar mejor los costes de inferencia de IA.[3]
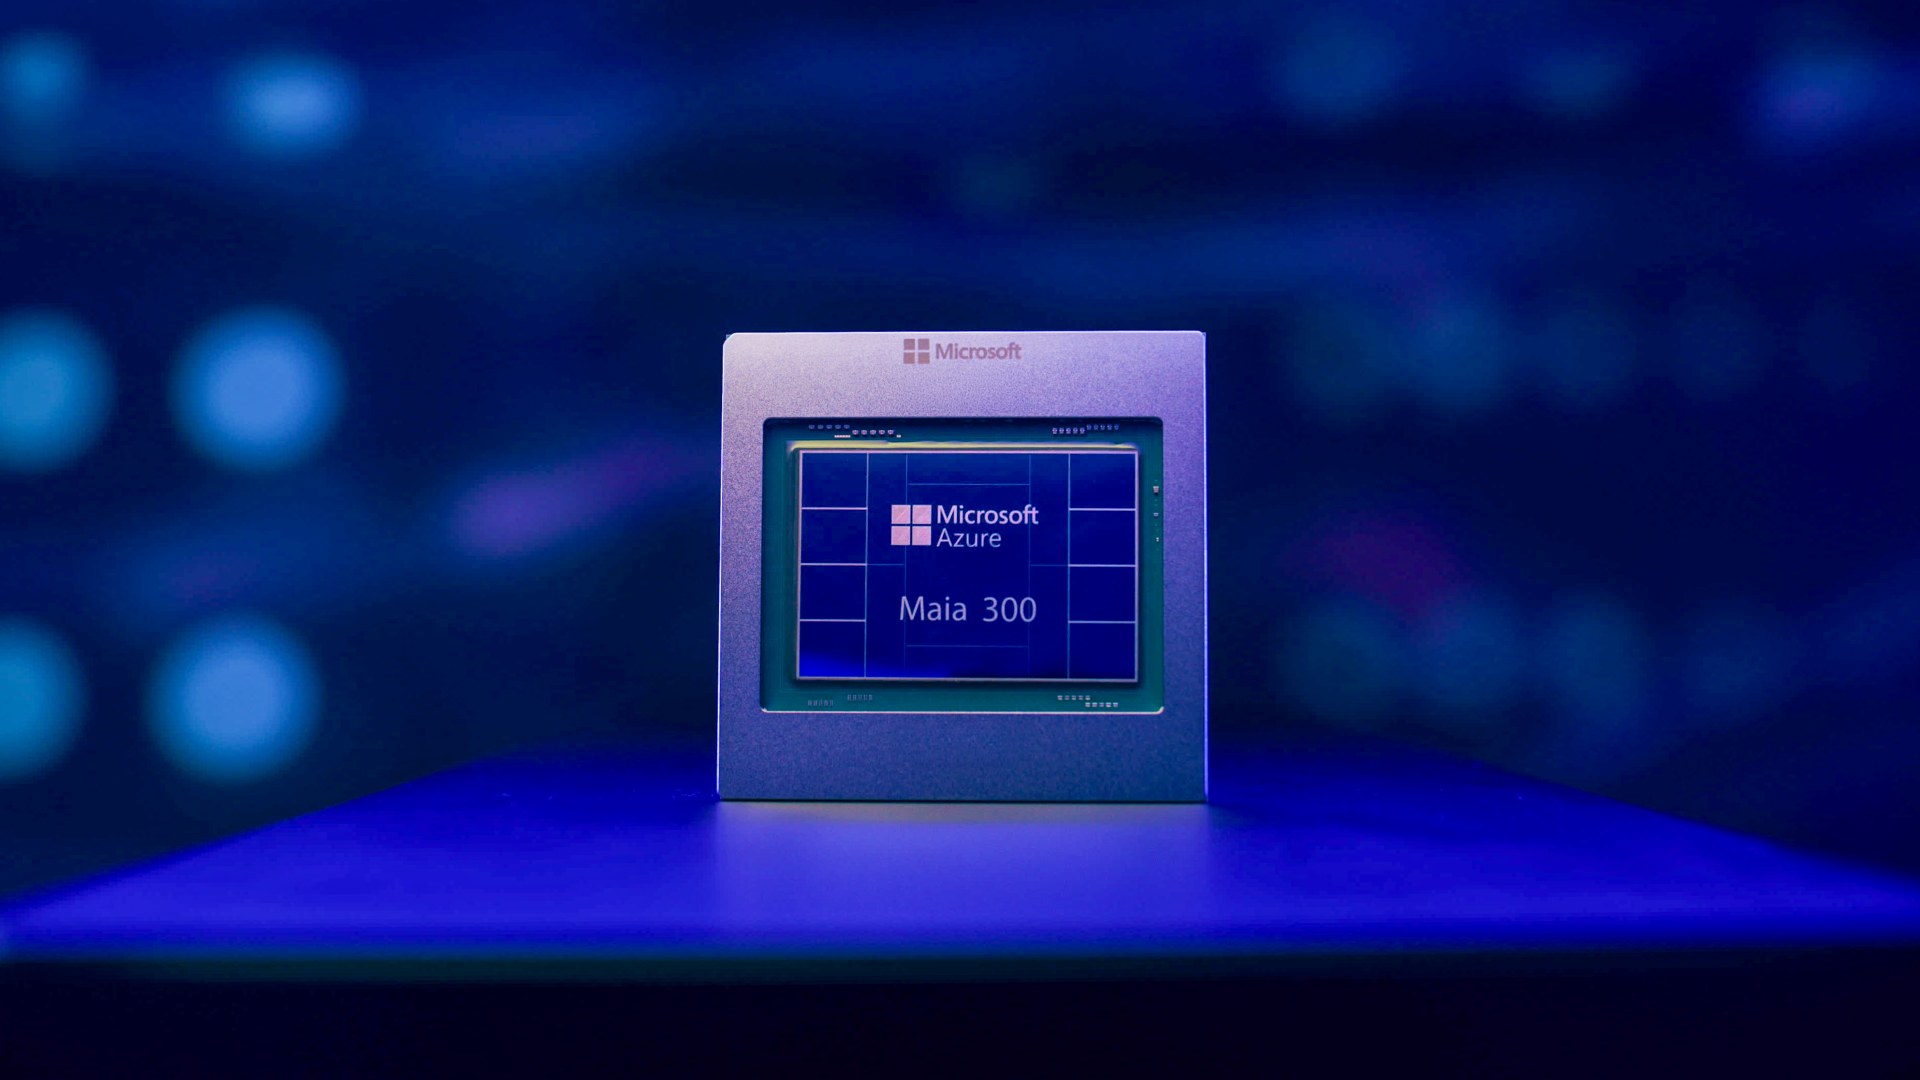
Imagen: Imagen oficial de portada del chip Azure Maia 300 de Microsoft (fuente: Microsoft)
Anthropic anuncia avances contra la destilación no autorizada, pero los resultados aún deben evaluarse a largo plazo
Anthropic ha revelado que, tras adoptar nuevas medidas contra la destilación no autorizada de modelos, las primeras pruebas indican que el volumen de datos que pueden recopilar los atacantes ha disminuido entre un 90 % y un 99 %. La destilación es una técnica habitual de aprendizaje automático que consiste en entrenar un modelo con las respuestas de otro más potente; la polémica gira en torno a si la extracción está autorizada o si elude las restricciones del servicio. Anthropic también reconoce que algunas medidas de protección obligan a los clientes legítimos a actualizar sus integraciones y que implican concesiones en materia de costes e ingresos. Estos resultados se basan en observaciones preliminares de la empresa y no significan que hayan desaparecido por completo todos los riesgos de extracción de capacidades de los modelos.[4]
NVIDIA y Cisco impulsan módulos ópticos de alta densidad para interconectar centros de datos de IA
NVIDIA y Cisco han anunciado una solución de módulos ópticos conectables USFP, destinada a la transmisión de alta velocidad dentro de grandes centros de datos de IA y con objetivos de diseño que incluyen 400 Gb/s por canal y una capacidad total de hasta 12,8 Tb/s. Las empresas afirman que, frente a los módulos ópticos conectables de 200 Gb/s por canal, la nueva solución puede cuadruplicar la densidad de ancho de banda y mejorar la eficiencia energética en torno a 1,3 veces. A medida que aumenta el tamaño de los modelos, la eficiencia depende no solo de los propios chips, sino también de la capacidad para transmitir datos entre miles de aceleradores. Sin embargo, pasar de las especificaciones y los planes de colaboración al despliegue en producción requiere validar el ecosistema de hardware, la compatibilidad y los datos de consumo energético real.[5]
Noticias breves
- Blueprints AI, una startup de diseño arquitectónico, ha presentado una nueva herramienta para generar automáticamente planos de construcción. El equipo subraya que, antes de presentar los documentos para obtener permisos, un arquitecto colegiado debe revisarlos y firmarlos; la IA no sustituye la responsabilidad legal de los profesionales.[6]
- WindBorne ha obtenido un contrato de adquisición de datos meteorológicos de la Fuerza Aérea de Estados Unidos, con un valor potencial cercano a los 50 millones de dólares. Los datos de observación recopilados por sus globos meteorológicos autónomos sirven a sus clientes y también se utilizan para mejorar los modelos de predicción meteorológica basados en IA.[7]
Observaciones del editor
Estas noticias parecen inconexas, pero en realidad abarcan una misma cadena de valor de la IA: Meta intenta que los agentes comprendan mejor las tareas continuas; Microsoft, NVIDIA y Cisco se esfuerzan por mejorar la eficiencia de la infraestructura necesaria para ejecutar estas tareas durante largos periodos; y Anthropic refuerza los límites de acceso a las capacidades y los datos de sus modelos. Conviene tener presente que una demostración tecnológica, una prueba interna y un despliegue real en producción no son lo mismo. Creemos que, en la próxima etapa, lo que marcará la diferencia probablemente será que los modelos puedan funcionar de forma fiable en procesos empresariales concretos, que los costes sigan bajando y que los usuarios puedan controlar de verdad la privacidad y la seguridad, no solo liderar una determinada prueba de referencia.
Fuentes de referencia
- Meta releases its first frontier model, Muse Wonder — TechCrunch, consultado el 2026-10-13
- Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents — Meta, consultado el 2026-10-13
- Microsoft to expand Azure Maia system to multi-gigawatt deployments — Microsoft, consultado el 2026-10-13
- Strengthening our defenses against distillation attacks — Anthropic, consultado el 2026-10-13
- NVIDIA and Cisco Introduce New Pluggable Optics Form Factor to Scale AI Factories — NVIDIA Newsroom, consultado el 2026-10-13
- This AI startup says it can generate permit-ready blueprints in minutes — TechCrunch, consultado el 2026-10-13
- WindBorne wins a hefty US Air Force contract for its balloon data — TechCrunch, consultado el 2026-10-13