Meta hat am 12. Oktober die Reihe Muse Wonder vorgestellt und damit erneut am Wettbewerb um führende große Sprachmodelle teilgenommen. Gleichzeitig arbeitet Microsoft an einem Fahrplan für den großflächigen Einsatz seiner Inferenzchips der nächsten Generation, während Anthropic über Fortschritte beim Schutz vor Angriffen durch Modelldestillation berichtet. Im Mittelpunkt stehen heute nicht nur Modellbewertungen, sondern auch das Gedächtnis von Agenten, Recheneffizienz und Sicherheitsgrenzen.[1][2][3][4]
Topmeldung des Tages: Meta stellt Muse Wonder vor und rückt Langzeitgedächtnis in den Mittelpunkt
Meta Superintelligence Labs hat zwei Frontier-Modelle veröffentlicht: Muse Wonder und Muse Wonder Full. Während Muse Spark vor allem auf geringe Latenz ausgelegt ist, konzentriert sich die Wonder-Reihe stärker auf komplexe Aufgaben, Programmierung und mehrstufige Ausführung. Meta zufolge können die neuen Modelle Aufgaben wie Versicherungsansprüche, Mietverträge und App-Entwicklung bearbeiten und erzielen bei mehreren vom Unternehmen veröffentlichten Benchmark-Tests konkurrenzfähige Ergebnisse. Dabei ist jedoch zu beachten, dass es sich vor allem um Testergebnisse von Meta handelt. Sie bedeuten nicht, dass die Modelle in verschiedensten realen Geschäftsszenarien bereits unabhängig überprüft wurden.[1][2]
Bei der Vorstellung hob Meta insbesondere zwei Fähigkeiten hervor: Active Memory (aktives Gedächtnis), das wichtige Informationen über den Nutzer über mehrere Sitzungen hinweg behält, und Active Focus (aktiver Fokus), das bei Hindernissen andere Ansätze erprobt, Fehler behebt und vor wichtigen Aktionen eine Bestätigung einholt. Damit sollen typische Probleme bei der alltäglichen Nutzung von Agenten angegangen werden: Ein Assistent sollte nicht nur aktuelle Fragen beantworten, sondern auch bei Aufgaben, die sich über Tage oder noch länger erstrecken, den Kontext verstehen, das Ziel im Blick behalten und bei unerwarteten Ereignissen die Absichten des Nutzers nicht eigenmächtig ändern. Wenn diese Fähigkeiten zuverlässig funktionieren, könnte sich KI von einem Werkzeug für einmalige Frage-Antwort-Runden zu einem Arbeitsassistenten entwickeln, der langfristig mitwirkt.[2]
Auch die Vermarktungspläne stehen fest: Muse Wonder wird Entwicklern über die Meta Model API und Muse Code angeboten. Laut TechCrunch kostet die API 4 US-Dollar pro Million Eingabetokens und 20 US-Dollar pro Million Ausgabetokens. Muse Wonder Full ist derzeit für Abonnenten von Muse Code verfügbar und wird nicht direkt über eine API angeboten. Meta plant außerdem, das neue Modell nach und nach in den Muse-Agenten zu integrieren und es zunächst Abonnenten bereitzustellen. Entscheidend werden künftig nicht einzelne Ranglistenplätze sein, sondern die Genauigkeit des Langzeitgedächtnisses, die tatsächliche Kontrolle der Nutzer über Datenschutzberechtigungen und die zuverlässige Ausführung komplexer Aufgaben zu vertretbaren Kosten.[1][2]
Nachrichten
Microsoft plant, Maia 300 ab 2027 einzusetzen – Inferenz-Effizienz wird zum Schwerpunkt im Chip-Wettbewerb
Microsoft stellte am 12. Oktober die weitere Roadmap für Azure Maia vor und plant, ab 2027 den Einsatz auf mehrere Gigawatt auszuweiten. Maia 200 übernimmt bereits einen Teil der Produktionslasten für Microsoft-Produkte; Maia 300 ist auf lange Kontexte, Dialoge mit niedriger Latenz und dauerhaft laufende mehrstufige Agenten ausgelegt. Microsoft erwartet, dass Maia 300 pro Megawatt 40 % mehr Tokens erzeugen kann als führende GPU-Lösungen. Der Durchsatz eines Racks mit 96 Beschleunigern soll bis zu siebenmal so hoch sein wie bei Maia 200. Dabei handelt es sich um von Microsoft genannte Design- und Leistungsziele, nicht um unabhängig überprüfte Vergleichswerte aus einer öffentlich zugänglichen Produktionsumgebung. Das zeigt, dass Microsoft die KI-Inferenzkosten durch die gemeinsame Optimierung von Chips und Software besser kontrollieren will.[3]
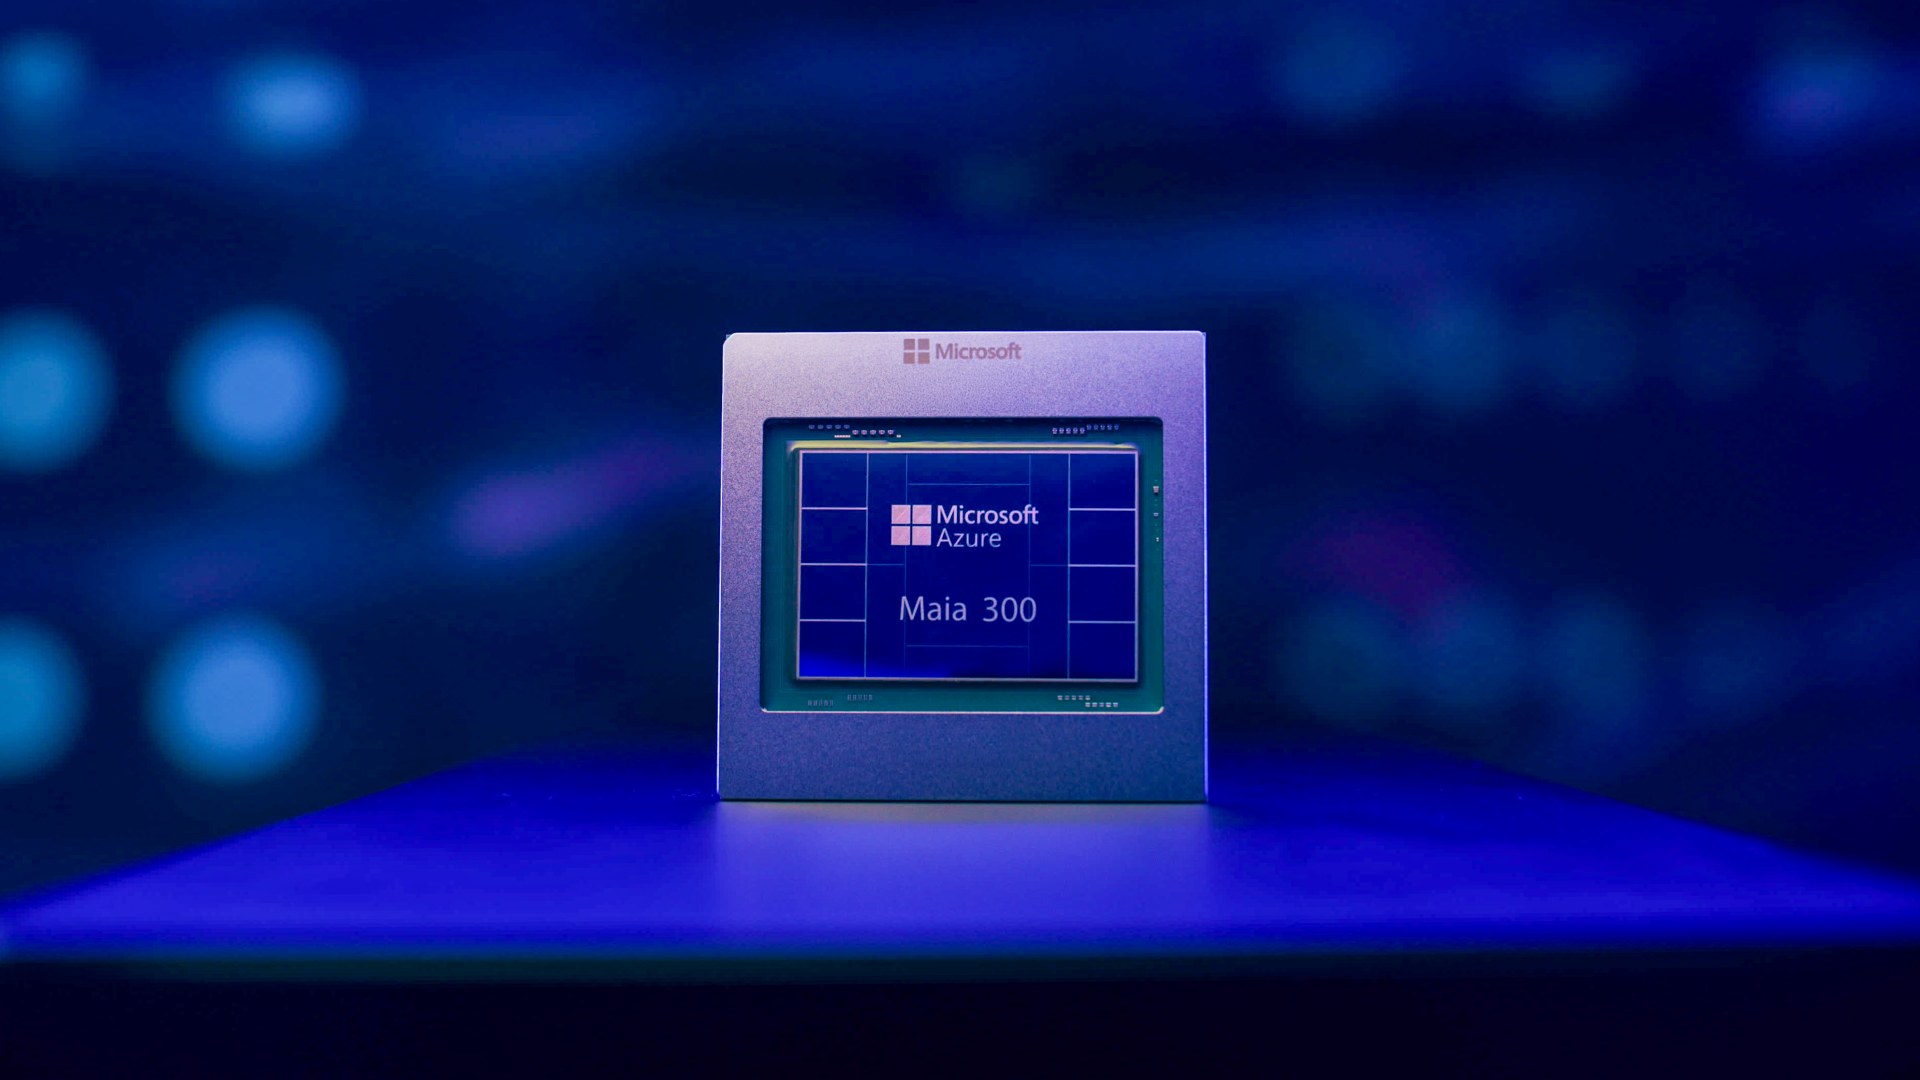
Bild: Offizielles Key Visual des Microsoft-Chips Azure Maia 300 (Quelle: Microsoft)
Anthropic meldet Fortschritte beim Schutz vor Destillation, doch die Wirksamkeit muss sich langfristig bewähren
Anthropic zufolge zeigen erste Erkenntnisse, dass Angreifer rund 90 bis 99 % weniger Daten erfassen konnten, nachdem neue Maßnahmen gegen nicht autorisierte Modelldestillation eingeführt wurden. Destillation ist eine gängige Technik des maschinellen Lernens, bei der die Ausgaben eines leistungsstärkeren Modells zum Trainieren eines anderen Modells verwendet werden. Umstritten ist, ob die Extraktion autorisiert ist oder Beschränkungen des Dienstes umgeht. Anthropic räumt zugleich ein, dass einige Schutzmaßnahmen normale Kunden dazu zwingen, ihre Integrationen zu aktualisieren, und Abwägungen zwischen Kosten und Umsatz mit sich bringen. Die Angaben zur Wirksamkeit beruhen auf frühen Beobachtungen des Unternehmens und bedeuten nicht, dass sämtliche Risiken der Extraktion von Modellfähigkeiten beseitigt sind.[4]
NVIDIA und Cisco forcieren hochdichte optische Module für die Vernetzung von KI-Rechenzentren
NVIDIA und Cisco kündigten eine steckbare optische USFP-Modullösung für Hochgeschwindigkeitsübertragungen in großen KI-Rechenzentren an. Zu den Designzielen zählen 400 Gb/s pro Kanal und eine Gesamtkapazität von bis zu 12,8 Tb/s. Die Unternehmen zufolge bietet die neue Lösung gegenüber steckbaren optischen Modulen mit 200 Gb/s pro Kanal die vierfache Bandbreitendichte und eine um etwa das 1,3-Fache verbesserte Energieeffizienz. Mit zunehmender Modellgröße hängt die Effizienz nicht nur von den Chips selbst ab, sondern auch davon, wie gut Daten zwischen Tausenden von Beschleunigern übertragen werden. Von den Spezifikationen und Kooperationsplänen bis zum tatsächlichen Einsatz in der Massenproduktion müssen jedoch noch Hardware-Ökosystem, Kompatibilität und reale Energieverbrauchsdaten überprüft werden.[5]
Kurzmeldungen
- Das Architektur-Startup Blueprints AI stellte ein neues Tool vor, das automatisch Bauzeichnungen erstellt. Das Team betont, dass vor der offiziellen Einreichung von Genehmigungsunterlagen weiterhin ein zugelassener Architekt die Pläne prüfen und unterzeichnen muss; KI kann die rechtliche Verantwortung von Fachleuten nicht ersetzen.[6]
- WindBorne erhielt einen Beschaffungsvertrag der US Air Force für Wetterdaten mit einem potenziellen Wert von knapp 50 Millionen US-Dollar. Die von autonomen Wetterballons erfassten Beobachtungsdaten werden sowohl Kunden bereitgestellt als auch zur Verbesserung von KI-Wettervorhersagemodellen genutzt.[7]
Einordnung der Redaktion
Diese Nachrichten wirken auf den ersten Blick unterschiedlich, decken aber tatsächlich dieselbe KI-Wertschöpfungskette ab: Meta versucht, Agenten Aufgaben über längere Zeit hinweg besser verstehen zu lassen; Microsoft, Nvidia und Cisco arbeiten daran, die Infrastruktur für die langfristige Ausführung solcher Aufgaben effizienter zu machen; Anthropic wiederum stärkt die Modellfähigkeiten und setzt Grenzen für den Datenzugriff. Dabei sollte man nicht vergessen, dass technische Demonstrationen, interne Tests und der reale Einsatz in der Produktion nicht dasselbe sind. Wir gehen davon aus, dass in der nächsten Phase vor allem entscheidend sein wird, ob Modelle zuverlässig in konkreten Geschäftsabläufen arbeiten können, ob die Kosten weiter sinken und ob Nutzer tatsächlich die Kontrolle über Datenschutz und Sicherheit behalten – und nicht bloß, wer bei einem Benchmark die Nase vorn hat.
Referenzquellen
- Meta releases its first frontier model, Muse Wonder — TechCrunch, abgerufen am 13.10.2026
- Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents — Meta, abgerufen am 13.10.2026
- Microsoft to expand Azure Maia system to multi-gigawatt deployments — Microsoft, abgerufen am 13.10.2026
- Strengthening our defenses against distillation attacks — Anthropic, abgerufen am 13.10.2026
- NVIDIA and Cisco Introduce New Pluggable Optics Form Factor to Scale AI Factories — NVIDIA Newsroom, abgerufen am 13.10.2026
- This AI startup says it can generate permit-ready blueprints in minutes — TechCrunch, abgerufen am 13.10.2026
- WindBorne wins a hefty US Air Force contract for its balloon data — TechCrunch, abgerufen am 13.10.2026